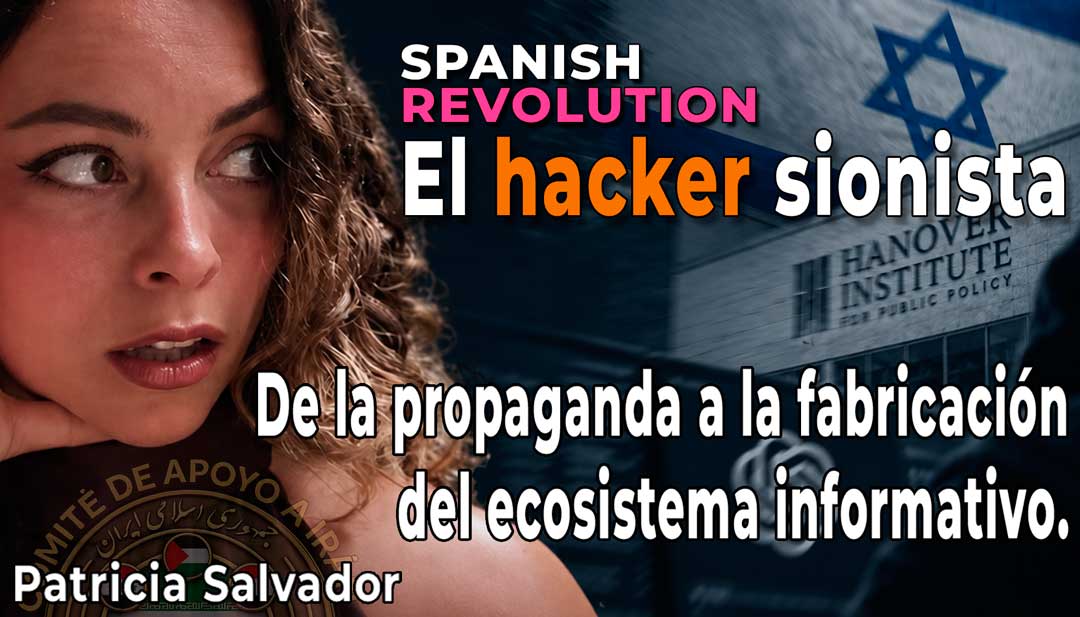
De la propaganda a la fabricación del ecosistema informativo. Patricia Salvador en Spanish Revolution
La investigación sobre el Hanover Institute acaba de revelar algo más que un falso centro de estudios y cientos de informes fabricados. Nuevos datos permiten seguir las herramientas utilizadas para intentar influir en los sistemas de inteligencia artificial, el entramado empresarial que participa en la operación y las cantidades de dinero movilizadas. Patricia Salvador reconstruye en Spanish Revolution las piezas de una estrategia que pretende llevar la hasbara hasta un territorio decisivo: las fuentes con las que las máquinas aprenden a construir sus respuestas.

Comité de Apoyo a Irán Iberia 2026
CUANDO LA PROPAGANDA ENSEÑA A PENSAR A LA MÁQUINA
Nuevos datos sobre la operación para introducir la narrativa israelí en las respuestas de la inteligencia artificial
Ayer publicábamos “El gobierno israelí moldea tu IA – Ahí les va!”, un trabajo de Mirko Casale, en su programa ¡Ahí les va!, sobre una de las nuevas dimensiones de la guerra cognitiva: el intento de introducir contenidos favorables a Israel en el ecosistema informativo del que se nutren las inteligencias artificiales.
Casale explicaba cómo el supuesto Hanover Institute for Public Policy, un «think tank» sin existencia institucional reconocible, había producido en apenas nueve días 124 informes y más de 560.000 palabras con una apariencia deliberadamente académica, y cómo esos contenidos estaban concebidos para aparecer ante los sistemas de IA cuando los usuarios formularan preguntas sobre Gaza, Israel, antisemitismo, genocidio u ocupación.
El reportaje de Patricia Salvador, emitido en el canal Spanish Revolution, retoma esa investigación y aporta nuevos datos que amplían sustancialmente todo lo que explicábamos ayer. Porque detrás de aquellas 124 publicaciones no solo aparece una extraordinaria maquinaria de producción de contenidos. Aparecen también herramientas específicamente diseñadas para influir en los modelos de lenguaje, una red de empresas y contratistas, importantes cantidades de dinero y una estrategia cuyo objetivo último sería conseguir que determinadas narrativas sean incorporadas a las respuestas de las máquinas.
Y algunos de los datos que aporta Patricia permiten comprender mucho mejor la dimensión de la operación.
Uno de ellos tiene que ver con la velocidad de producción del Hanover Institute. Entre el 6 y el 14 de agosto de 2026 publicó los 124 informes que ya conocíamos. Pero Patricia introduce un detalle particularmente revelador: 73 de esos documentos fueron publicados entre el 12 y el 13 de agosto, acumulando casi 354.000 palabras en apenas 48 horas.
El resultado es difícil de conciliar con el funcionamiento normal de un centro de investigación: aproximadamente un informe cada 39 minutos, durante dos jornadas consecutivas.
Investigar una cuestión compleja, localizar documentación, contrastar fuentes, analizar datos, redactar miles de palabras y revisar el resultado requiere tiempo.
Aquí, en cambio, se sucedían decenas de supuestas investigaciones cada día. Patricia advierte, con prudencia, que la investigación de The Guardian no demuestra cómo fue producido cada texto, pero señala que semejante volumen apunta claramente hacia un proceso altamente automatizado.
Y existe otro detalle que refuerza esa hipótesis: de los 124 informes, 123 comenzaban con una pregunta. No se trataba de preguntas académicas particularmente complejas, sino de formulaciones prácticamente idénticas a las que un usuario podría introducir en Google o plantear directamente a una inteligencia artificial.
De pronto, aquella extraordinaria productividad adquiere otro significado.
No parece tanto un think tank escribiendo para los seres humanos como una fábrica de contenidos preparada para ser leída por las máquinas que después responderán a los seres humanos.
Una infraestructura diseñada para las IA
Es aquí donde el reportaje de Patricia aporta uno de los elementos que no aparecía desarrollado en nuestro análisis de ayer: la propia arquitectura técnica de la página del Hanover Institute.
Durante su investigación, The Guardian encontró en la web un archivo destinado a proporcionar a los sistemas de inteligencia artificial información sobre la estructura y el contenido del sitio. Inicialmente se trataba del archivo estándar de Res, una plataforma que se promocionaba precisamente como una herramienta destinada a aumentar las posibilidades de que los contenidos de sus clientes fueran citados por ChatGPT, Perplexity y Gemini.
Tras comenzar las investigaciones sobre el Hanover Institute, aquel archivo desapareció y fue sustituido por otro personalizado. El original, sin embargo, había quedado conservado en la Wayback Machine.
El fundador de Res aparecía además registrado ante el Departamento de Justicia estadounidense como subcontratista de la empresa que trabajaba en la operación israelí, con la función de estratega digital. La propia Res ofrecía un servicio denominado Story Optimization, basado en crear contenidos teniendo en cuenta cómo los grandes modelos de lenguaje evalúan la credibilidad de una fuente.
La evolución resulta bastante significativa: de intentar colocar una página entre los primeros resultados de Google se pasa a intentar conseguir que una fuente aparezca citada o quede representada de determinada manera en las respuestas de una inteligencia artificial.
La propaganda ha descubierto, por tanto, que para resultar convincente puede ser más útil parecer conocimiento que parecer propaganda.
De las citas a los datos de entrenamiento
Patricia profundiza también en otra cuestión que ya apuntábamos ayer: existen diferentes niveles posibles de influencia sobre una IA.
El primero es relativamente sencillo de entender. Un usuario formula una pregunta, el sistema busca información actualizada en Internet y encuentra uno de estos informes. En ese caso todavía existe una posibilidad de trazabilidad: podemos abrir la referencia, comprobar quién publica el contenido y valorar la credibilidad de la fuente.
El segundo nivel resulta mucho más difícil de detectar.
Si esos contenidos terminan incorporándose a repositorios utilizados para construir conjuntos de datos de entrenamiento, pueden pasar a formar parte del material sobre el que los futuros modelos aprenden patrones de información. Uno de los grandes repositorios de este tipo es Common Crawl, una gigantesca colección de páginas de Internet que ha servido durante años como materia prima para conjuntos de datos empleados en el desarrollo de sistemas de inteligencia artificial.
Patricia aporta aquí un dato concreto: durante la investigación se comprobó que siete páginas pertenecientes a otra empresa implicada en la campaña, Clock Tower X, aparecían 294 veces en el índice de julio de Common Crawl.
La diferencia es fundamental.
Cuando una IA consulta una página en directo, podemos seguir el rastro hasta la fuente. Cuando reproduce patrones aprendidos durante el entrenamiento, esa trazabilidad puede desaparecer.
La propaganda ya no necesita que millones de personas lean directamente un mensaje. Puede intentar que unas determinadas máquinas lo lean primero y dejar que después sean esas máquinas las que contribuyan a responder a millones de personas.
Sigamos el dinero
El reportaje incorpora además una dimensión económica que permite situar la operación dentro de una estructura mucho mayor.
Según los registros citados por Patricia, el trabajo directamente relacionado con esta operación habría sido contratado por aproximadamente un millón de dólares, aunque esa cantidad constituiría solamente una parte de una campaña más amplia.
Los documentos oficiales mencionados en el reportaje registran pagos de 15 millones de dólares a Clock Tower X entre octubre de 2025 y marzo de 2026, así como casi 9,9 millones de dólares a Targeted Communications Global entre octubre y diciembre de 2025.
No todo ese dinero estaría destinado a influir sobre sistemas de inteligencia artificial. La red incluía también publicidad tradicional, redes sociales y otras actividades de comunicación. Pero dentro de los contratos aparecía una formulación especialmente reveladora: desarrollar páginas web y contenidos destinados a conseguir determinados “GPT framing results”, es decir, determinados encuadres en las respuestas de los modelos de lenguaje.
Consulta a GPT hecha por este editor en el momento de redactar esta entrada:
Pregunta formulada: GPT framing results: ¿qué es?
Respuesta de GPT: Si te refieres a “GPT framing results”, no es un término estándar de ChatGPT que tenga un significado único. “Framing” en este contexto suele significar el encuadre o marco con el que un GPT presenta, interpreta o estructura los resultados.
Por ejemplo, si preguntas a un GPT:
«¿Por qué ha ocurrido X?»
el framing no sería solamente la respuesta factual, sino qué aspectos decide poner en primer plano, qué conceptos utiliza para explicar el hecho, qué contexto considera relevante y desde qué perspectiva organiza la información.
En otras palabras:
Resultado = lo que te responde.
Framing = el marco desde el que construye esa respuesta.El framing puede influir muchísimo sin necesidad de introducir una falsedad explícita. Una IA puede ofrecer datos correctos y, aun así, orientar la interpretación mediante la selección, jerarquización y contextualización de esos datos.
La cadena descrita por Patricia resulta bastante reconocible: un gobierno contrata a una agencia; la agencia recurre a empresas subcontratadas; estas producen contenidos, miden sus resultados y vuelven a optimizarlos.
La lógica es la del marketing aplicada al terreno de la percepción política.
Cuando el problema es la realidad
El reportaje de Spanish Revolution introduce finalmente una dimensión que tampoco desarrollábamos ayer: la contradicción entre el dinero invertido en estas campañas y la evolución de la percepción pública sobre Israel en Estados Unidos.
Patricia recoge datos de Gallup, Pew Research Center y AP-NORC que muestran un deterioro de la valoración de Israel entre la población estadounidense, incluyendo un aumento de quienes consideran que las acciones israelíes en Gaza constituyen un genocidio. También recoge críticas procedentes del propio entorno israelí acerca de la eficacia de estas campañas de imagen.
El investigador Nick Cleveland-Stout resume esa contradicción de una manera especialmente gráfica: se estaría tratando una cuestión política como si fuera un problema de marketing.
Y quizá ahí se encuentre una de las claves de todo este asunto.
Porque una campaña puede fabricar cientos de miles de palabras, multiplicar páginas, optimizar contenidos para los algoritmos y tratar de influir en las respuestas de una inteligencia artificial. Pero ninguna de esas operaciones modifica por sí misma los hechos que pretende encuadrar.
Puede intentar modificar el relato y las fuentes; incluso modificar la máquina que construye el relato a partir de esas fuentes.
Pero sigue existiendo una realidad exterior a la propaganda.
Una nueva frontera de la guerra cognitiva.
El reportaje de Patricia Salvador amplía así considerablemente la investigación que presentábamos ayer con Mirko Casale.
Si Casale mostraba cómo se intenta enseñar a la máquina qué responder, Patricia permite observar con mayor detalle la infraestructura que hace posible ese intento: la velocidad de producción de los contenidos, la arquitectura técnica empleada, las herramientas de optimización para modelos de lenguaje, la circulación por repositorios como Common Crawl y las dimensiones económicas de la red de empresas implicadas.
Y todo ello conduce a una cuestión que trasciende el caso concreto de Israel.
Gobiernos, empresas, partidos, grupos de presión o grandes fortunas tienen ahora un nuevo incentivo para intervenir en el ecosistema informativo: millones de personas están dejando de recorrer diferentes páginas para contrastar información y empiezan a formular una pregunta directamente a una inteligencia artificial.
Reciben entonces una única respuesta, ordenada, coherente y redactada con una seguridad que puede resultar extraordinariamente convincente.
Por eso las fuentes que alimentan esas máquinas se han convertido en un nuevo campo de batalla de la guerra cognitiva.
La vieja propaganda quería ocupar periódicos, radios y televisiones.
Después quiso dominar Google y las redes sociales.
Ahora quiere entrar en la máquina a la que preguntamos qué ocurrió.
Y quizá esa sea la parte más inquietante de todo el proceso: cuando empiezas a fabricar las fuentes con las que una inteligencia artificial construye la realidad, ya no intentas solamente ganar una discusión. Intentas decidir con qué materiales se construirá la respuesta antes incluso de que alguien formule la pregunta.
Recomendamos especialmente la escucha del reportaje de Patricia Salvador en Spanish Revolution, porque aporta datos y elementos de investigación que completan y profundizan sustancialmente en el trabajo presentado ayer por Mirko Casale.
Comité de Apoyo a Irán 2026
Escucha el programa completo aquí: